한눈에 보기
- 무엇: 파이토치(PyTorch) 코드를 조금만 고쳐 구글 TPU에서 돌리게 해 주는 ‘TorchTPU’를 오픈소스로 공개했어요. TPU는 구글이 만든 AI 전용 칩이에요.
- 누가: 구글이 메타(Meta)의 파이토치 팀과 함께 개발했어요.
- 언제: 미국 태평양 시간 10월 20일 오전(한국 시간 10월 21일 새벽 1시께), 산호세에서 열린 PyTorch Conference 2026에서 공개했어요.
- 얼마: TorchTPU 자체는 아파치 2.0 라이선스로 무료 공개예요. TPU 사용료는 구글 클라우드 요금제를 따라요.
- 어디서: 깃허브(github.com/google-pytorch/torch_tpu)에서 받을 수 있어요. 구글 클라우드 TPU에 설치해 써요.
TorchTPU는 파이토치에서 TPU를 ‘tpu’라는 장치 이름으로 쓰게 해 줘요. 구글은 device=’cuda’를 ‘tpu’로 바꾸는 정도의 작은 수정이면 된다고 설명해요.
지금까지는 PyTorch/XLA에 맞춰 코드를 많이 고치거나 JAX(구글의 또 다른 머신러닝 프레임워크)를 배워야 했어요. TorchTPU는 그 수고를 줄이는 것을 목표로 해요.
기존 torch_xla와 뭐가 다른가요?
지금까지 파이토치로 TPU를 쓰려면 PyTorch/XLA(torch_xla)를 거쳐야 했어요.
torch_xla는 연산을 모아 두었다가 한꺼번에 실행하는 방식이에요. 그래서 코드가 생각한 때에 바로 돌지 않는 경우가 있었어요.
작은 변경에도 그래프를 다시 컴파일해 디버깅(코드의 잘못된 부분을 찾아 고치는 일)이 까다로웠다고 허깅페이스는 설명해요.
TorchTPU는 TPU를 파이토치의 새 백엔드(연산을 실제로 처리하는 하부 장치)로 더해요. 기본은 코드를 한 줄씩 바로 돌리는 즉시 실행(eager) 모드예요.
속도가 필요하면 torch.compile로 미리 묶어 컴파일해 TPU 활용도를 높이고 메모리 사용을 줄일 수 있어요.
허깅페이스는 트랜스포머스·디퓨저스로 허깅페이스 모델을 돌릴 때는 기존 보조 도구 Optimum TPU가 더는 필요 없다고 밝혔어요.
| 항목 | torch_xla | TorchTPU |
|---|---|---|
| 실행 방식 | 모아서 한꺼번에(지연 실행) | 즉시 실행(eager)이 기본 |
| 코드 수정 | 손볼 곳이 많음 | 장치 이름 등 조금 |
| 디버깅 | 재컴파일이 잦아 까다로움 | 평소 파이토치처럼 |
| 속도 내기 | 그래프 컴파일 | torch.compile로 선택 |
| 구글 권장 | TorchTPU로 대체 | 새 작업·이전 모두 권장 |
설치와 모델 올리기는 이렇게 해요
TPU가 달린 가상 머신(VM)에서는 설치가 명령 한 줄이에요. 뒤의 옵션은 가벼운 CPU용 파이토치를 받으라는 뜻이에요.
pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpu깃허브 설명서는 버전을 torch_tpu==0.2.0으로 고정해 설치하도록 안내해요. 현재 공개 버전은 0.2.0이에요.
트랜스포머스(Transformers) v5에서는 모델을 불러올 때 device_map=”tpu”를 넣으면 모델이 TPU에 올라가요.
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu",
)
이미지 생성 라이브러리 디퓨저스(Diffusers)는 pipe.to(“tpu”)로 TPU를 써요. 배포용으로는 compile 한 줄을 더하면 된다고 허깅페이스는 설명해요.
깃허브 소개에 따르면 TorchTPU는 파이썬 3.11 이상을 지원하고, Llama·Qwen·ResNet 같은 모델 예제를 함께 제공해요.
성능은 어느 정도라고 하나요?
아래 수치는 구글·허깅페이스가 발표한 값이에요. 숫자마다 무엇과 비교했는지가 달라서 기준을 같이 봐야 해요.
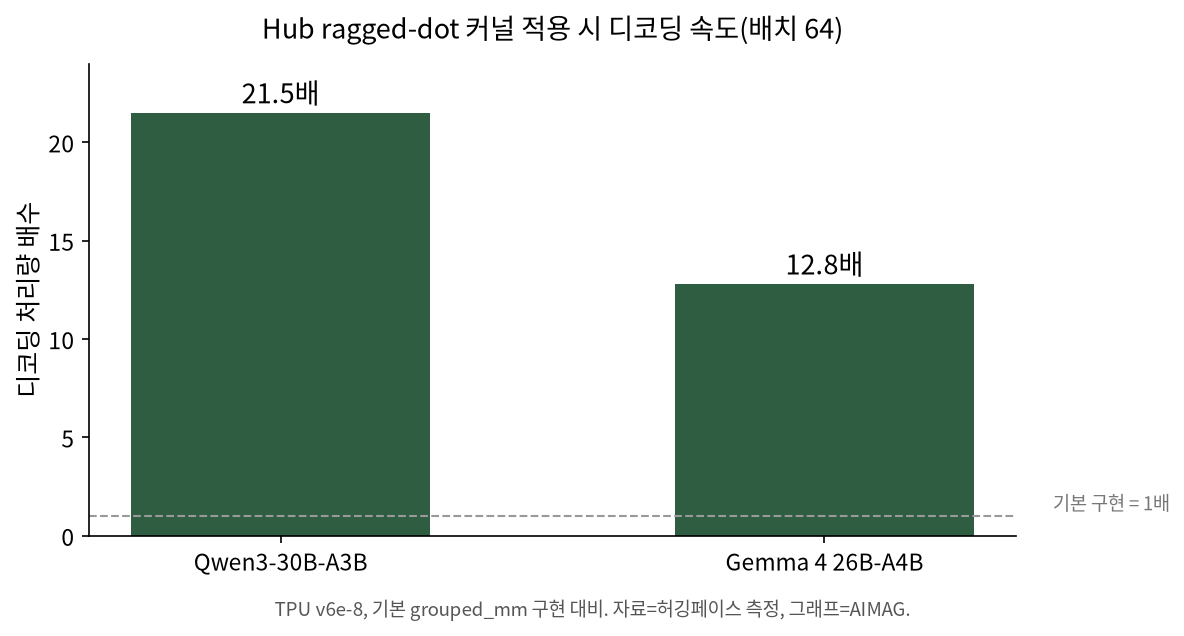
허깅페이스는 TPU v6e-8에서 배치(한 번에 같이 처리하는 요청 묶음) 64로 디코딩 속도를 쟀어요. 디코딩은 모델이 답을 한 토큰씩 만들어 내는 단계예요.
Hub의 ragged-dot 커널로 바꾸자 Qwen3-30B-A3B는 21.5배, Gemma 4 26B-A4B는 12.8배 빨라졌어요. 커널은 칩에서 실제 계산을 맡는 작은 프로그램이에요.
이 배수는 같은 TPU에서 기본 구현 grouped_mm을 1배로 둔 커널 교체 전후 비교예요. GPU나 torch_xla와 견준 값은 아니에요.
학습 효율과 칩 수 확장
구글은 TorchTitan으로 학습한 Qwen 3 8B에서 최대 52% MFU(모델 연산 활용률)를 냈다고 밝혔어요. MFU는 칩이 낼 수 있는 계산 능력 중 실제로 쓴 비율이에요.
그래서 52%는 52% 빨라졌다는 뜻이 아니에요. 칩 능력의 절반쯤을 실제 계산에 썼다는 뜻이에요.
칩 수 확장 실험은 다른 모델인 Qwen3 235B MoE로 했어요. MoE는 여러 ‘전문가’ 신경망 가운데 일부만 골라 쓰는 모델 구조예요.
Ironwood TPU를 1,024개에서 8,192개로 8배 늘려도 MFU는 28.8%에서 27.1%로 거의 그대로였어요. 칩과 함께 일감도 늘린 약한 확장(weak scaling) 시험이에요.
JAX·GPU 코드와 견주면
PyTorch 블로그는 JAX와도 견줬어요. TPU v7 64개에서 Qwen3 235B MoE 학습 처리량은 1,828 TPS(초당 토큰 수)로, JAX(MaxText) 1,937 TPS의 약 94%였어요.
추천 모델 DLRM v2는 TPU v7x 32칩에서 한 단계 18.3ms로 JAX와 같았어요. 허깅페이스 모델 4,917개 중 4,821개(98%)는 오류 없이 돌았어요.
대표 구조의 모델 657개 중 638개(97%)는 GPU 기준 결과와 비교해 허용 오차 안에서 수치 검증을 통과했어요.
GPU용으로 짠 외부 코드(Muse Glimmer 30B)를 옮긴 학습은 MFU 36%였어요.
같은 모델을 커스텀 커널 없이 순수 파이토치로 쓴 버전은 MFU 38%였어요. 옮긴 코드도 효율이 크게 떨어지지 않았다는 뜻이에요.
| 수치 | 대상·조건 | 기준·측정 |
|---|---|---|
| 21.5배 | Qwen3-30B-A3B 디코딩 | 커널 교체 전후(HF) |
| 12.8배 | Gemma 4 26B-A4B 디코딩 | 커널 교체 전후(HF) |
| MFU 52% | Qwen 3 8B 학습 | 칩 능력 대비(구글) |
| MFU 28.8%→27.1% | Qwen3 235B, 1,024→8,192칩 | 약한 확장(구글) |
| 약 94% | Qwen3 235B, TPU v7 64개 | JAX 처리량 대비(구글) |
| 98% | HF 모델 4,917개 실행 | 오류 없이 실행(구글) |
학습 수치는 구글이 측정한 값이고, 독립 기관이 재현했는지는 아직 확인되지 않았어요.
추론 쪽은 PyTorch 블로그가 SemiAnalysis의 외부 벤치마크(InferenceX)를 인용했어요. 다만 그 결과도 구글이 골라 소개한 것이에요.
지금 써 봐도 될까
구글 클라우드 TPU를 쓸 수 있는 개발자라면 바로 시험할 수 있어요. TorchTPU를 설치하고 허깅페이스 Hub의 모델을 “tpu”로 보내면 돼요.
도입 전에는 쓰려는 모델이 TPU에서 잘 도는지 작은 작업으로 먼저 확인하는 게 좋아요. 비용은 TPU 사용료가 중심이니 작업량 기준으로 미리 따져 보세요.
기존 torch_xla 사용자라면 이전을 검토할 때예요. 구글이 새 작업은 TorchTPU로 시작하고 기존 작업도 옮기라고 권장하기 때문이에요.
일반 독자에게는 AI를 어떤 칩에서 돌릴지 고르는 선택지가 넓어진다는 뜻이에요. 하드웨어 쪽 흐름은 엔비디아가 공개한 AI 데이터센터용 랙 설계 기사와 함께 보면 비교가 돼요.
대단한 점과 아쉬운 점
대단한 점은 TPU가 GPU·CPU처럼 파이토치의 장치로 들어왔다는 거예요. vLLM, SGLang, TorchTitan, Ray, 허깅페이스 같은 도구에서 함께 쓸 수 있어요.
오픈소스라 누구나 코드를 보고 쓸 수 있고, 메타 파이토치 팀과 함께 만들었어요. JAX 대비 약 94%라는 구글 측정값도 첫 공개 버전으로는 가까운 수준이에요.
흐름으로 보면 AWS도 자체 칩 Trainium용 torch-neuronx로 파이토치를 지원해요. 칩을 만드는 회사들이 파이토치를 표준 입구로 삼는 흐름이고, TorchTPU는 그 흐름에 대한 구글의 답이에요.
아쉬운 점은 아직 첫 버전이라는 거예요. 도입 전에 볼 제약은 이래요.
- TPU에서 돌린 트랜스포머스 테스트 중 96.5%가 통과했어요. 허깅페이스가 보고한 문제 34건 중 19건이 고쳐졌어요.
- 버전은 0.2.0이에요. 구글은 앞으로 6~12개월 동안 프로덕션(실서비스)용으로 다듬겠다고 밝혔어요.
- FlexAttention(어텐션 계산을 바꿔 쓰는 파이토치 기능)은 아직 지원하지 않아요.
- 지금은 TPU에서 torch.compile을 쓰면 임시 제약으로 dynamic=False가 자동 설정돼요. 입력 모양이 바뀌어도 재컴파일 없이 처리하는 기능(bounded dynamism)은 아직 기본으로 켜져 있지 않고 개발 중이에요.
- TPU 하나는 프로세스 하나만 쓸 수 있어요. 그래서 강화학습에서 학습과 생성을 한 칩에 같이 올리는 구성이 바로 되지 않아요.
- 여러 계산을 동시에 흘려보내는 Stream 기능은 GPU와 똑같이 동작하지 않아요.
- TPU는 사실상 구글 클라우드에서 빌려 써야 해요.
확장성: 무엇을 해 볼 수 있나요?
작게는 쓰던 파이토치 코드를 TPU VM에 올려 즉시 실행 모드로 돌려 볼 수 있어요. 속도가 필요하면 torch.compile로 바꿔 비교해 보면 돼요.
크게는 TorchTitan으로 분산 학습을, llm-d로 분산 추론(학습한 모델로 답을 내는 처리)을 TPU에서 시험할 수 있어요. 구글은 GPU와 TPU를 같은 창구로 골라 쓰는 구성을 소개했어요.
같이 발표된 llm-d 사례: 처리량 4배
고객 Zenteiq는 llm-d 기반 GKE Inference Gateway로 전체 추론 처리량이 4배 넘게 늘었다고 밝혔어요. 서버 부하와 캐시(이전 계산 결과)를 보고 요청을 나눠 보낸 효과예요.
하루 생성 토큰(모델이 다루는 글의 조각)은 TPU v6e 1,000개당 14.7억 개에서 59.7억 개로 늘었다고 해요.
이 4배는 TorchTPU 자체의 속도 향상이 아니라 요청 배분 방식의 효과예요. 고객이 직접 밝힌 수치이고, 이전 구성의 자세한 조건은 공개되지 않았어요.
같이 발표된 LiteRT
구글은 온디바이스(기기 안) 추론 도구 LiteRT(옛 TensorFlow Lite)를 파이토치 생태계에 더했다고 밝혔어요. TorchTPU와는 별개로 함께 발표된 도구예요.
직접 돌릴 수 있는 모델에 관심이 있다면 노트북에서도 돌아가는 엔비디아 네모트론 모델 기사도 참고가 돼요.
아직 모르는 것
- 학습 성능 수치를 독립 기관이 재현한 결과는 아직 확인되지 않았어요.
- 한국어 모델에서 얼마나 잘 도는지는 발표문에 따로 나오지 않았어요.
- 통과하지 못한 테스트가 어떤 모델·기능에 몰려 있는지는 저장소 이슈로 하나씩 공개되고 있어요.
- VeRL(강화학습)과 TPU 에이전트 모음은 미리보기 단계라, 정식 품질은 더 지켜봐야 해요.
자주 묻는 질문
TorchTPU는 무료인가요?
소프트웨어는 아파치 2.0 라이선스로 무료 공개예요. 다만 TPU를 돌리는 구글 클라우드 사용료는 따로 들어요.
기존 torch_xla 코드는 어떻게 되나요?
구글은 TorchTPU가 PyTorch/XLA를 대체한다며, 새 작업은 TorchTPU로 시작하고 기존 작업도 옮기라고 권장해요. 옮길 때는 코드를 조금 고치고 모델이 잘 도는지 확인해야 해요.
GPU 없이 TPU만으로 쓸 수 있나요?
네. 설치할 때 CPU용 파이토치를 받고, 모델을 “tpu”로 보내면 돼요.
출처
- 구글 클라우드 — TorchTPU 오픈소스 공개. 발표, 52% MFU, Zenteiq 사례, LiteRT의 근거예요. 게시일: 2026-10-20. 확인일: 2026-10-21.
- PyTorch 블로그 — TorchTPU 소개. 칩 수 확장, JAX 비교, 모델 호환률, 제약, 로드맵의 근거예요. 게시: 2026-10-20 09:02 PDT(한국 시간 10-21 01:02). 확인일: 2026-10-21.
- 허깅페이스 — TorchTPU로 TPU를 그대로 쓰기. 설치 명령, torch_xla 비교, 21.5배·12.8배, 96.5%·34건 중 19건의 근거예요. 게시일: 2026-10-20. 확인일: 2026-10-21.
- 구글 클라우드 문서 — TPU에서 파이토치 실행. PyTorch/XLA 대체·이전 권장의 근거예요. 확인일: 2026-10-21.
- 깃허브 — google-pytorch/torch_tpu. 아파치 2.0 라이선스, 파이썬 3.11 이상, 모델 예제의 근거예요. 확인일: 2026-10-21.
- PyPI — torch-tpu 0.2.0. 공개 버전의 근거예요. 확인일: 2026-10-21.
- SemiAnalysis — TPU InferenceX. PyTorch 블로그가 인용한 외부 추론 벤치마크예요. 게시일: 2026-09-07. 확인일: 2026-10-21.
- 깃허브 — aws-neuron/torch-neuronx. AWS Trainium용 파이토치 지원 비교 자료예요. 확인일: 2026-10-21.
- PyTorch Conference 2026 행사 페이지. 행사 일정·장소(산호세)의 근거예요. 확인일: 2026-10-21.
- 긱뉴스 — TorchTPU 오픈소스 공개 소개. 국내 소개 글이에요. 확인일: 2026-10-21.
대표 이미지: 구글 클라우드
구글 검색에서 AIMAG 소식을 먼저 보려면
AI 보조 초안 · 편집부 검수