한눈에 보기
- 무엇: 엔비디아가 공개 AI 모델 네모트론 3.5 Super VL(120B)과 노트북용 Bolt(24GB)를 내놨어요. 둘 다 글과 이미지를 함께 읽고, 여러 단계를 스스로 처리하는 AI 에이전트용 모델이에요.
- 누가: 엔비디아(공개 모델 묶음 네모트론)
- 언제: 2026년 10월 15일(미국 시간) 발표했어요. Super VL과 Bolt 74B-A9B는 바로 받을 수 있고, 4GB짜리 Bolt E4B는 10월 23일 나올 예정이에요.
- 얼마: 모델 파일은 무료로 받을 수 있어요. 이용 조건(라이선스)은 상업적 사용도 허용하는 OpenMDW-1.1이에요.
- 어디서: 허깅페이스(Hugging Face), 오픈라우터(OpenRouter), 모델스코프(ModelScope), 엔비디아 NIM에서 써 볼 수 있어요.
- 한국: 라이선스 원문에 지역 제한 조항은 없어요. 다만 Super VL의 추가 학습 언어 목록에 한국어는 없어요.
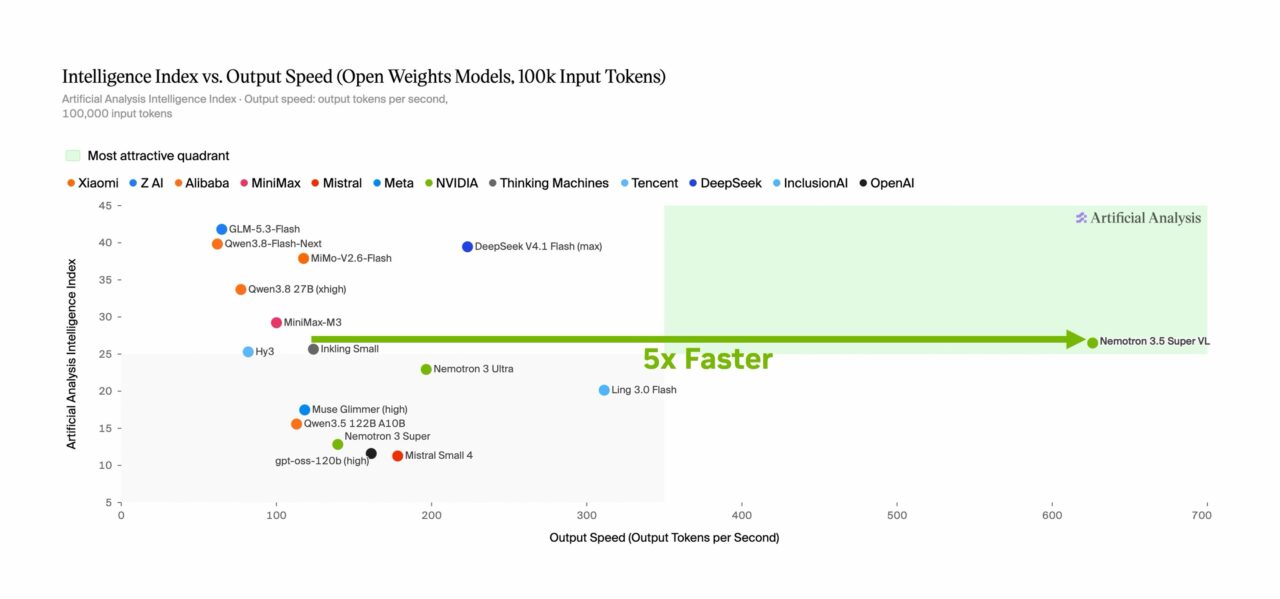
서버용 Super VL과 노트북용 Bolt가 더해지면서, 네모트론은 데이터센터부터 24GB 메모리 노트북까지 같은 계열 공개 모델로 고를 수 있게 됐어요. 내 서버에 올리고 내 데이터로 더 학습시킬 수 있다는 점이 닫힌 모델과 가장 큰 차이예요. 다만 성능 숫자는 아직 대부분 회사 발표예요.
Super VL은 120B, Bolt는 24GB: 무엇이 나왔나요?
네모트론(Nemotron)은 엔비디아가 만드는 공개 AI 모델 묶음이에요. 모델 파일(가중치)뿐 아니라 학습 데이터와 학습 방법도 함께 공개하는 게 특징이에요.
이번에 나온 모델은 세 가지예요.
- Super VL: 전체 1,200억(120B) 개 파라미터 가운데 한 번에 120억(12B) 개만 쓰는 모델이에요. 글, 이미지, PDF 같은 문서, 영상을 읽고 도구를 불러 일을 처리해요.
- Bolt 74B-A9B 24GB: 740억 개 중 90억 개만 쓰고, 2비트로 줄여 24GB 메모리에 들어가게 만든 로컬용 모델이에요.
- Bolt E4B 4GB: 4GB에 들어가는 작은 모델이에요. 음성 비서, 게임 캐릭터처럼 빠르게 대화하는 용도예요. 10월 23일 공개 예정이에요.
용어를 한 줄씩 풀면 이래요.
- 파라미터: 모델이 학습하며 조정한 숫자예요. 많을수록 대체로 똑똑하지만 무겁고 느려져요.
- MoE(전문가 혼합): 모델 안에 여러 ‘전문가’ 부분을 두고, 질문마다 일부만 골라 쓰는 구조예요. 그래서 120B 모델이 12B만큼만 계산해요.
- 양자화: 숫자를 더 적은 자릿수로 저장해 모델 크기를 줄이는 방법이에요. 2비트는 아주 많이 줄인 편이라, 그만큼 정확도를 지키는 기술이 중요해요.
어느 규모에 무엇을 쓰나요?
기존 Lightning(8월 공개)과 Ultra까지 합치면 다섯 가지예요. 엔비디아는 쓰는 규모에 맞춰 모델을 하나씩 고를 수 있다고 설명했어요. 모델 카드에서 확인한 값으로 정리했어요.
| 모델 | 크기(전체 / 한 번에 쓰는 양) | 읽는 것 | 잘 맞는 곳 | 공개 시점 |
|---|---|---|---|---|
| 네모트론 3 Ultra | 5,500억 / 550억(550B / 55B) | 글 | 가장 어려운 추론(여러 단계로 따져 답을 찾는 일), 여러 에이전트를 지휘하는 계획 | 2026년 6월 |
| 네모트론 3.5 Super VL | 1,200억 / 120억(120B / 12B) | 글·이미지·문서·영상 | 기업 서버에서 문서·웹 조사·코딩 에이전트. 책상 위 AI 컴퓨터 DGX Spark 1대나 H200 GPU 1장에서도 실행 | 2026년 10월 15일 |
| 네모트론 3.5 Lightning | 300억 / 30억(30B / 3B) | 글 | 양이 많은 텍스트 작업을 빠르게 처리 | 2026년 8월 |
| 네모트론 3.5 Bolt 74B-A9B 24GB | 740억 / 90억(74B / 9B), 2비트·24GB | 글·이미지·영상 | RTX Spark 노트북, DGX Spark, 지포스 RTX PC에서 로컬 에이전트 | 2026년 10월 15일 |
| 네모트론 3.5 Bolt E4B 4GB | 4GB(세부 크기 미공개) | 대화 | 음성 비서, 게임 캐릭터, 젯슨 같은 소형 기기 | 2026년 10월 23일 예정 |
문맥 길이는 한 번에 넣을 수 있는 글의 양이에요. Super VL·Lightning·Ultra는 최대 100만 토큰, Bolt 74B는 최대 25만 6,000토큰이에요(모델 카드 기준). 토큰은 모델이 글을 자르는 단위예요.
Super VL은 무엇을 잘한다고 했나요?
엔비디아가 내세운 건 속도와 문서 이해예요. 아래 숫자는 모두 회사 발표나 회사가 고른 측정 결과예요.
| 회사 발표 숫자 | 무엇과 비교했나·측정 조건 |
|---|---|
| 같은 급 공개 모델보다 최대 5배 빠름 | Artificial Analysis 지표, 입력 10만 토큰, 베이스텐(Baseten) 서버 기준. 초당 600토큰 넘게 출력 |
| 엔비디아 최대 추론 모델과 비슷한 정확도 | 파라미터는 약 5분의 1. 비교 대상은 네모트론 3 Ultra(550B) |
| 에이전트 평가 Hermes Bench 63.44%, LangChain 평가 87.05% | 에이전트 도구 회사들이 만든 시험. 같은 표에서 네모트론 3 Ultra는 56.33%, 84.3% |
| 차트 이해 시험(CharXiv) 80.8% | 파이썬 코드 실행을 쓰면 84% |
| 최대 8배 많은 사용자, 첫 응답 지연 85% 감소 | 엔비디아 다이나모(Dynamo) 사용, B200 GPU 16장, 사용자당 초당 50토큰 기준 |
학습에는 약 26조 토큰을 썼고, 이후 약 380만 개 예제와 강화학습으로 다듬었다고 해요. 강화학습은 잘한 답에 점수를 주며 모델을 고치는 방법이에요. 엔비디아는 웹 페이지와 PDF 속 표·그래프를 읽고, 그 내용을 바탕으로 다음 행동까지 하는 데 강하다고 설명했어요.
회사들이 이미 자기 데이터로 추가 학습하고 있다고도 밝혔어요. 예를 들어 스케일 AI는 스카이댄스의 거래처 신용 처리 에이전트를, 램프(Ramp)는 영수증 사진을 정리된 데이터로 바꾸는 작업을 만들고 있다고 해요. 아틀라시안, 크라우드스트라이크, 퍼플렉시티, 세일즈포스도 제품에 붙이고 있다고 엔비디아는 밝혔어요.
Bolt는 노트북에서 무엇을 하나요?
Bolt 74B-A9B는 Super VL 120B를 압축한 뒤, 2비트로 줄인 상태에 맞춰 다시 학습해 24GB 메모리에 들어가게 한 모델이에요. 다른 앱을 켜 둔 채로도 쓸 수 있게 만들었다고 해요. 웹 검색, 글쓰기, 코드 고치기 같은 일을 클라우드에 보내지 않고 내 컴퓨터에서 맡기는 용도예요.
엔비디아는 Bolt가 같은 급 공개 모델 중 PinchBench 1위, BrowseComp 2위라고 밝혔어요. 다만 허깅페이스 모델 카드 표에서는 Qwen3.6-35B-A3B(88.07)가 Bolt(87.82)보다 PinchBench 점수가 조금 높아요. 둘 다 에이전트가 웹과 도구를 다루는 능력을 보는 시험이에요. llama.cpp, 올라마(Ollama), LM 스튜디오, 언슬로스(Unsloth), vLLM 같은 로컬 실행 프로그램에서 돌릴 수 있어요. 10월 16일 미국에서 나온 RTX Spark 노트북을 겨냥한 모델이에요. 노트북 쪽 소프트웨어 변화는 RTX Spark 노트북 로컬 AI 소프트웨어 정리 기사에서 볼 수 있어요.
한국 이용자에게는 뭐가 달라지나요?
가장 큰 점은 라이선스예요. 다섯 모델 중 모델 카드를 확인한 네 개(Super VL, Bolt 74B, Lightning, Ultra)는 모두 OpenMDW-1.1을 따라요. 이 라이선스는 사용·수정·배포를 폭넓게 허용하고, 모델이 만든 결과물에는 제한을 두지 않아요. 한국 기업도 자기 서버에 올려 추가 학습할 수 있는 길이 열린 셈이에요. 실제 도입 전에는 라이선스 원문을 직접 확인하는 게 좋아요.
한국어는 아직 조심해서 봐야 해요. Super VL 모델 카드는 영어 외에 프랑스어·독일어·이탈리아어·일본어·스페인어·중국어로 추가 학습했다고 적었고, 한국어는 목록에 없어요. Bolt 74B 카드에는 입력 언어로 한국어가 적혀 있지만, 주로 지원하는 언어 목록에는 빠져 있어요. 한국어 문서 처리 품질은 직접 시험해 봐야 알 수 있어요(추정).
Bolt를 돌릴 RTX Spark 노트북은 국내에서도 10월 16일 출시된다고 에이수스와 델이 밝혔어요. 다만 공식 원화 가격은 보도로 확인되지 않았어요. 고가 전문가용 제품이 중심이라, 개인보다는 회사·연구실이 먼저 써 볼 가능성이 커요(추정).
대단한 점과 아쉬운 점
| 대단한 점 | 아쉬운 점·우려 |
|---|---|
| 모델 파일, 학습 데이터, 학습 방법까지 공개했어요(모델 카드·엔비디아 블로그). | 속도·정확도 숫자는 대부분 엔비디아 발표나 엔비디아가 고른 비교예요. |
| 글·이미지·문서·영상을 한 모델로 처리해, 텍스트용과 이미지용 모델을 따로 둘 필요가 줄어요. | ‘같은 급 PinchBench 1위’라는 회사 설명과 모델 카드 표 점수가 엇갈려요. 무엇을 같은 급으로 봤는지는 설명이 없어요. |
| 서버부터 4GB 기기까지 같은 계열 모델로 고를 수 있어요. | Super VL 추가 학습 언어에 한국어가 없어요. 한국어 품질은 따로 확인해야 해요. |
확장성: 무엇을 해 볼 수 있나요?
- 예전에는 문서 속 표와 그래프를 읽으려면 글 모델과 이미지 모델을 따로 이어야 했다면, 이제 한 모델로 PDF 요약과 수치 추출을 시험해 볼 수 있어요.
- 사내 문서가 밖으로 나가면 안 되는 곳이라면, Super VL을 자체 서버에 올리고 사내 자료로 추가 학습(파인튜닝)하는 방식을 검토해 볼 수 있어요. 엔비디아는 모델 학습 도구 NeMo와 공개 데이터셋을 함께 내놨어요.
- 24GB 이상 메모리를 가진 PC나 DGX Spark가 있다면, Bolt를 올라마나 LM 스튜디오로 받아 로컬 에이전트로 써 볼 수 있어요. 메모리보다 큰 모델을 노트북에서 돌릴 때 생기는 일은 로컬 LLM 실행기 Janas를 직접 돌려 본 기사에서 볼 수 있어요.
아직 모르는 것
- 회사 밖 독립 평가가 쌓이면 ‘5배 빠름’이 얼마나 유지될지는 아직 몰라요.
- 한국어 문서·대화에서의 품질은 공식 자료에 나오지 않아요.
- Bolt E4B 4GB의 세부 크기, 라이선스, 성능은 10월 23일 공개 전이라 확인할 수 없어요.
- 2비트로 줄인 Bolt가 원래 크기 모델보다 정확도를 얼마나 잃는지는 회사 표만 있어요.
자주 묻는 질문
네모트론 3.5는 무료로 써도 되나요?
모델 파일은 무료로 받을 수 있고, 상업적 사용도 허용돼요. Super VL과 Bolt 74B는 OpenMDW-1.1 라이선스를 따르고, 배포할 때는 라이선스 사본과 저작권 표시를 함께 넣어야 해요. 오픈라우터나 NIM처럼 남의 서버로 쓰면 그 서비스 요금은 따로예요.
네모트론 3.5는 한국어를 지원하나요?
공식적으로 한국어를 잘한다고 밝힌 건 아니에요. Super VL 모델 카드의 추가 학습 언어 목록에 한국어는 없고, Bolt 74B는 입력 언어 목록에만 한국어가 있어요.
내 노트북에서도 돌아가나요?
메모리가 24GB 넘게 남는 엔비디아 GPU 기기라면 Bolt 74B를 노려 볼 만해요. 엔비디아는 RTX Spark 노트북, 지포스 RTX PC, DGX Spark를 실행 환경으로 꼽았어요. Super VL은 DGX Spark 1대나 데이터센터 GPU가 필요해요.
출처
- Kari Briski, NVIDIA Blog, “Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models,” 2026-10-15(미국 시간), 확인 2026-10-16 — 링크
- Chris Alexiuk·Chintan Patel, NVIDIA Technical Blog, “NVIDIA Nemotron 3.5 Super VL Powers Specialized Agents with Multimodal Reasoning,” 2026-10-15 — 링크
- Hugging Face, nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 모델 카드, 확인 2026-10-16 — 링크
- Hugging Face, nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB 모델 카드, 확인 2026-10-16 — 링크
- Hugging Face, nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-BF16·nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-BF16 모델 카드, 확인 2026-10-16 — Lightning · Ultra
- OpenMDW License Agreement, version 1.1, 확인 2026-10-16 — 링크
- 윤현종, 씨넷코리아, 에이수스 프로아트 P16·P14 16일 국내 출시, 2026-10-14 — 링크
- 양정민, 이코노믹리뷰, 델 XPS 16 크리에이터 에디션 16일 국내 출시, 2026-10-08 — 링크
대표 이미지: 엔비디아
구글 검색에서 AIMAG 소식을 먼저 보려면
AI 보조 초안 · 편집부 검수