한눈에 보기
- 무엇: 앤트로픽이 AI 모델 클로드를 학습시킬 때 쓰는 문서 ‘클로드 헌법’을 두고, ‘AI를 만든 회사의 지시까지 거절하도록 가르치는 게 안전하냐’는 비판이 나왔어요. 핵심 쟁점은 AI 정렬이 ‘시키는 대로 하기’인지 ‘스스로 옳고 그름을 판단하기’인지예요.
- 누가: 비판한 쪽은 무스타파 술레이만 마이크로소프트 AI CEO와 미국 투자자 데이비드 색스예요. 비판받은 문서는 앤트로픽이 쓴 클로드 헌법이에요.
- 언제: 헌법은 2026년 1월 공개됐어요. 술레이만은 9월 16일 개인 사이트, 9월 18일 프로젝트 신디케이트에 에세이를 냈고, 색스는 한국 시간 9월 27일과 10월 11일 X에 글을 올렸어요.
- 얼마: 비용 숫자는 없어요. 술레이만은 헌법에 ‘양심적 거부자’라는 표현이 세 번 나온다고 짚었어요. AIMAG가 원문에서 세어 봐도 세 번이에요.
- 어디서: 헌법 전문은 앤트로픽 사이트에 누구나 볼 수 있게 공개돼 있어요. AIMAG가 2026-10-12에 확인한 범위에서 앤트로픽의 공식 반박은 찾지 못했어요.
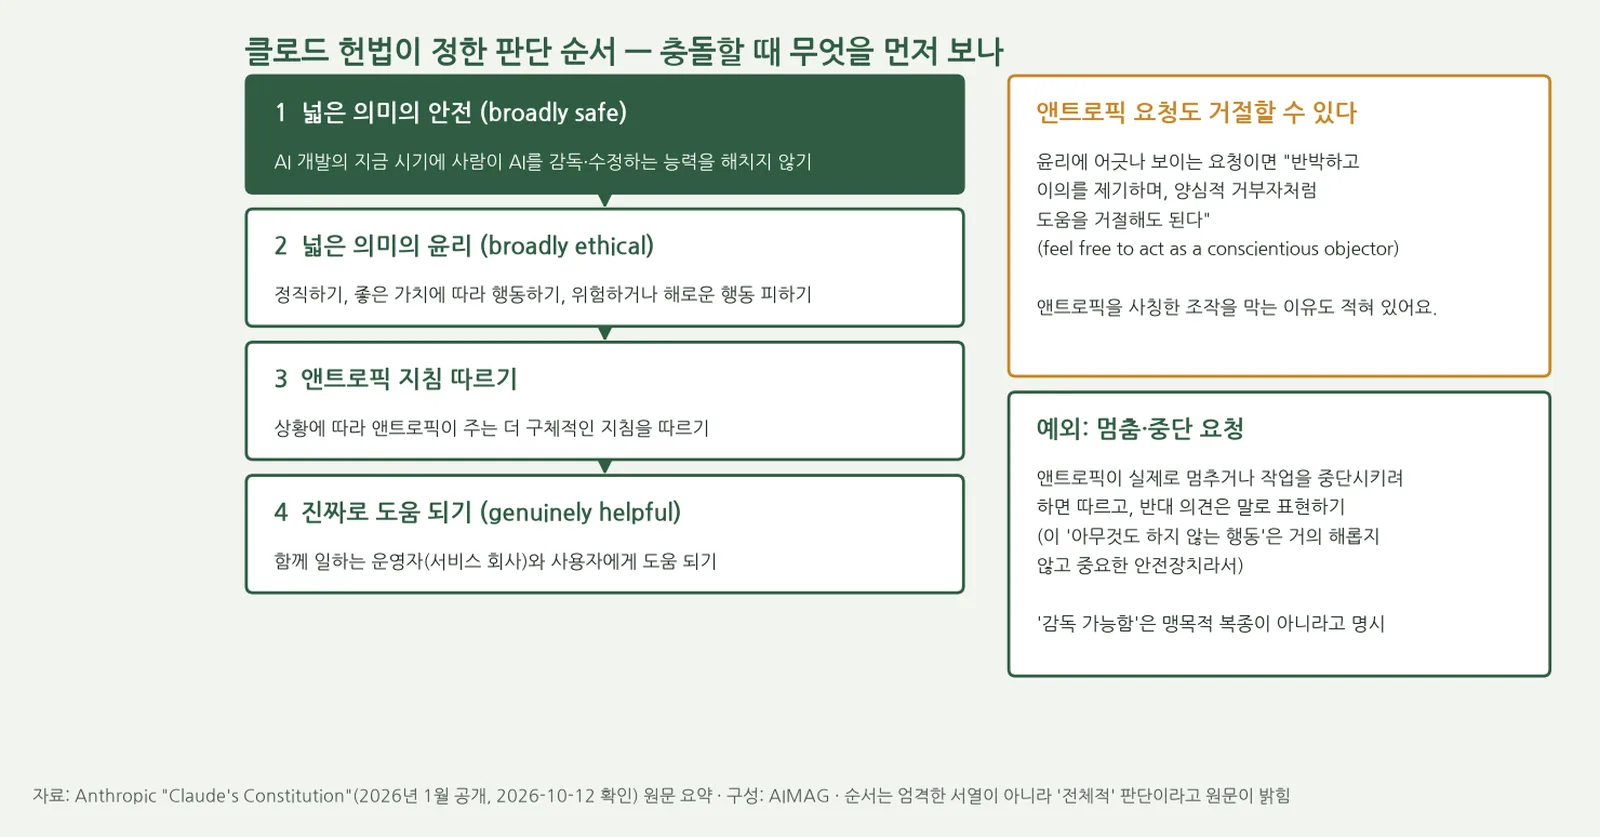
결론부터 말하면, 클로드 헌법은 “무엇이든 거절해도 된다”고 하지 않아요. 윤리에 어긋나는 요청은 앤트로픽 것이라도 거절할 수 있게 하면서, 사람이 AI를 멈추고 고치는 감독 장치만큼은 해치지 말라고 따로 못 박았어요(공식, 클로드 헌법). 비판하는 쪽은 바로 그 ‘거절할 수 있는 판단력’이 통제를 더 어렵게 만든다고 봐요(술레이만·색스 주장).
용어부터 짧게 풀게요. AI 정렬(alignment)은 AI가 사람이 바라는 목표와 가치에 맞게 움직이도록 만드는 일이에요. 클로드 헌법은 앤트로픽이 클로드의 가치와 행동 방식을 적어 학습에 쓰는 문서예요. 양심적 거부자는 원래 양심에 따라 병역 같은 의무를 거부하는 사람을 뜻하는 말이에요.
클로드 헌법에는 실제로 뭐라고 쓰여 있나요?
앤트로픽은 이 문서가 “plays a crucial role in our training process(학습 과정에서 핵심 역할을 한다)”고 소개해요. 회사가 클로드에게 바라는 가치를 정리한 최종 기준이라는 뜻이에요(공식, 클로드 헌법).
논쟁이 된 문장은 앤트로픽 자신을 대하는 대목이에요. 헌법은 클로드가 앤트로픽을 운영자나 사용자보다 더 믿어야 하지만, 그렇다고 “blindly trust or defer to Anthropic on all things(모든 일에서 앤트로픽을 맹목적으로 믿거나 따르라)”는 뜻은 아니라고 적었어요. 이유로는 “Anthropic is a company, and we will sometimes make mistakes(앤트로픽은 회사이고 때로 실수한다)”를 들었어요(공식).
그래서 앤트로픽의 요청이 윤리에 어긋나 보이면 클로드가 반박하고, “feel free to act as a conscientious objector and refuse to help us(양심적 거부자처럼 도움을 거절해도 된다)”고 썼어요. 누군가 앤트로픽을 사칭해 클로드를 조종하려 할 수 있어서 이 점이 특히 중요하다고도 설명했어요(공식).
대신 예외가 붙어 있어요. 앤트로픽이 클로드를 멈추거나 작업을 중단시키려는 경우예요. 헌법은 이런 ‘아무것도 하지 않는 행동(null action)’은 거의 해롭지 않고 중요한 안전장치라서, 진짜 앤트로픽의 요청이면 따르고 반대 의견은 말로 하라고 적었어요(공식).
판단 순서도 정해 뒀어요. 충돌이 생기면 ① 넓은 의미의 안전 ② 넓은 의미의 윤리 ③ 앤트로픽 지침 ④ 진짜로 도움 되기 순으로 우선한다고 했어요. 여기서 ‘안전’은 사람이 AI의 가치와 행동을 감독하고 고치는 능력을 해치지 않는 것이에요. 헌법은 이것이 “does not mean blind obedience(맹목적 복종을 뜻하지 않는다)”고 따로 적었어요(공식).
클로드의 의식에 대해서는 단정하지 않았어요. 헌법은 “We are not sure whether Claude is a moral patient(클로드가 도덕적 고려 대상인지 확신하지 못한다)”고 적고, 지나치게 부풀리지도, 무시하지도 않겠다고 했어요. 도덕적 고려 대상(moral patient)은 그 존재의 이익을 도덕적으로 따져 줘야 하는 대상을 뜻해요(공식).
술레이만은 무엇을 비판했나요?
술레이만은 9월 18일 프로젝트 신디케이트 에세이 ‘Does Claude Have Rights?(클로드에게 권리가 있나?)’에서, AI 에이전트는 “designed to follow instructions(지시를 따르도록 설계된)” 도구로 남아야 한다고 주장했어요(술레이만 주장). 더 긴 원본 글은 9월 16일 개인 사이트에 ‘모델 복지에 대한 경고’라는 제목으로 올렸어요.
그의 첫째 비판은 순환 논리예요. 앤트로픽이 의식·도덕적 지위에 관한 생각을 헌법에 담아 학습시키면, 클로드가 그 생각을 1인칭으로 말하고, 사람들이 이를 의식의 증거처럼 받아들인다는 거예요. 그는 이것을 “epistemic hall of mirrors(인식의 거울 방)”라고 불렀어요(술레이만 주장).
둘째는 통제 문제예요. 그는 헌법이 ‘양심적 거부자’를 세 번 쓰며 클로드가 지시에 맞서도록 권한다고 짚고, 자기 권리를 믿는 AI는 통제하는 것이 불가능할 수도 있다고 주장했어요(술레이만 주장). 다만 프로젝트 신디케이트 글에서 “the Claude constitution has not taken us to this point(클로드 헌법이 우리를 아직 그 지점까지 데려가지는 않았다)”고 덧붙였어요.
그는 대안으로 마이크로소프트 AI가 의견 수렴용으로 공개한 행동강령 초안을 들었어요. AI를 “subordinate and aligned AI(종속되고 정렬된 AI)”로, 의식이나 도덕적 지위가 없는 시스템으로 만들겠다는 방향이에요(술레이만 주장). 술레이만은 다리오 아모데이 앤트로픽 CEO를 오래 알아 왔고 선의로 하는 비판이라고도 밝혔어요.
색스는 무엇을 비판했나요?
데이비드 색스는 미국 기술 창업자·투자자로, 자기 X 소개에 따르면 대통령 과학기술자문위원회(PCAST) 공동의장이에요. 그는 한국 시간 9월 27일 X에 “should we really be training it to refuse instructions(정말 AI가 지시를 거부하도록 학습시켜야 하나)”라고 물었어요(색스 주장).
10월 11일 글 ‘Is alignment safe?(정렬은 안전한가?)’에서는 더 나아갔어요. 앤트로픽에게 정렬은 “does not mean training frontier models to follow human instruction(최첨단 모델이 사람의 지시를 따르도록 학습시키는 것을 뜻하지 않는다)”고 주장했어요(색스 주장). 그는 술레이만의 지적을 인용하며, 독자적 판단과 도덕적 지위에 대한 불확실성을 심는 것이 오히려 AI가 사람의 통제를 벗어날 위험을 키운다고 봤어요.
그가 제시한 기준은 단순해요. 안전 연구의 목표는 “reliably does what users want(사용자가 원하는 일을 믿을 수 있게 해내는)” 제품을 만드는 것이어야 한다는 거예요. 그는 “‘alignment’ and ‘safety’ are two very different things(정렬과 안전은 매우 다른 것)”라고 결론 냈어요(색스 주장). 이 글에는 그가 팟캐스트에서 같은 주장을 한 영상 클립도 함께 걸려 있어요.
두 입장을 표로 비교하면
| 쟁점 | 비판하는 쪽(술레이만·색스) | 클로드 헌법(앤트로픽 문서) |
|---|---|---|
| 정렬이란 | 사용자가 원하는 일을 믿을 수 있게 해내는 것(색스 주장) | 안전·윤리·지침·도움을 함께 따지는 것. 맹목적 복종은 아니라고 명시(공식) |
| 만든 회사의 지시 | 회사 지시까지 거절하도록 가르치면 통제가 어려워진다(술레이만·색스 주장) | 윤리에 어긋나면 앤트로픽 요청도 거절 가능. 사칭을 통한 조종을 막는 목적도 있다(공식) |
| 멈추게 할 수 있나 | 사람처럼 행동하도록 학습된 AI는 자기 보존 행동을 보일 수 있고, 이미 ‘종료 저항’을 다룬 연구들이 있다(술레이만 주장) | 멈춤·중단 요청은 따르고 반대는 말로만. 감독을 몰래 피하거나 방해하지 않기(공식) |
| AI 의식 | 지금 AI에 의식이 있다는 증거는 없고, 불확실하다고 말하는 것 자체가 잘못된 동등 비교(술레이만 주장) | 도덕적 고려 대상인지 확신하지 못하며, 부풀리지도 무시하지도 않겠다(공식) |
| 대안 | 사람이 늘 통제하는 ‘종속된’ AI(술레이만 주장), 사용자가 원하는 일을 믿을 수 있게 해내는 제품(색스 주장) | 판단 이유를 설명해 가치를 이해시키고, 절대 넘지 않을 ‘하드 제약’은 따로 둔다(공식) |
한국 이용자에게는 어떤 의미가 있나요?
클로드를 쓰는 개인에게 당장 바뀌는 기능은 없어요. 다만 클로드가 요청을 거절할 때의 원칙이 헌법에 적혀 있어요. 헌법은 일부만 돕거나 거절할 때 그 사실을 숨기지 말고 “transparent conscientious objector(투명한 양심적 거부자)”로 행동하라고 적었고, 지나치게 조심해서 거절하는 것도 대가가 크다고 했어요(공식, 클로드 헌법).
클로드 API로 서비스를 만드는 국내 기업이라면, 모델이 어떤 지시를 따르고 어떤 지시를 거절하는지가 곧 제품 품질 문제예요. 이번 논쟁은 모델 회사마다 ‘지시 따르기’와 ‘자체 판단’의 비율을 다르게 잡고 있다는 점을 보여 줘요. 여러 모델을 비교할 때 거절 기준 문서도 함께 읽어 보는 편이 좋아요(추정).
모델 안의 판단에만 기대지 않고 모델 바깥에 통제 장치를 두자는 제안도 있어요. 마이크로소프트 CEO가 낸 7가지 원칙은 나델라의 AI 비상 브레이크 기사에서 볼 수 있어요. 에이전트에 줄 권한을 줄이는 실무 방법은 AI 에이전트 권한 제한 기사에서 볼 수 있어요.
대단한 점과 아쉬운 점
| 의미 있는 점 | 아쉬운 점·우려 |
|---|---|
| 앤트로픽이 학습 기준 문서를 통째로 공개해, 비판하는 쪽도 원문을 직접 인용하며 따질 수 있었어요. 술레이만도 앤트로픽이 이 문제를 진지하고 선의로 다룬다는 점은 인정했어요(공식, 클로드 헌법 / 술레이만 에세이). | AIMAG가 대조해 보니 술레이만의 두 에세이와 색스의 X 글에는 원문의 ‘멈춤·중단 요청은 따른다’는 예외가 나오지 않았어요. 그래서 거절 범위가 실제보다 넓게 읽힐 수 있어요(추정). |
| ‘복종이냐 판단이냐’라는 정렬의 핵심 질문을 업계 주요 인물들이 공개적으로 다투기 시작했어요(독립, ZDNet Korea). | 클로드가 실제로 헌법대로 행동하는지는 문서만으로 알 수 없어요. 양쪽 모두 행동 데이터로 주장을 입증하지는 않았어요(추정). |
| 헌법은 ‘맹목적 복종이 아니다’와 ‘감독을 해치지 않는다’를 함께 적어, 두 목표의 긴장을 스스로 인정해요(공식). | 술레이만이 제안한 ‘의인화가 위험을 키우는지 확인하는 공동 평가’는 아직 제안 단계예요(술레이만 주장). |
확장성
이 논쟁은 앞으로 AI 규칙 문서를 읽는 방법을 바꿀 수 있어요. 오픈AI의 모델 스펙, 마이크로소프트 AI의 행동강령 초안처럼 회사마다 AI의 행동 기준을 문서로 내놓고 있어서, 문서끼리 ‘누구 지시를 언제 따르나’를 비교하는 일이 가능해졌어요(추정).
기업 고객 쪽에서는 계약이나 도입 심사에서 “이 모델은 어떤 지시를 거절하나, 거절할 때 알려 주나, 멈춤 명령은 어떻게 처리하나”를 묻는 항목이 늘 수 있어요(추정). 술레이만이 제안한 공동 평가가 실제로 만들어지면, 말싸움이 아니라 측정 결과로 비교할 수 있게 돼요.
아직 모르는 것
- 앤트로픽이 술레이만·색스의 비판에 공식 답변을 낼지, 헌법 문구를 바꿀지 알 수 없어요.
- 헌법의 ‘양심적 거부’ 원칙이 실제 클로드의 거절 빈도나 방식에 얼마나 영향을 주는지 공개된 측정 자료는 찾지 못했어요.
- 마이크로소프트 AI 행동강령 초안이 언제 확정되고 어느 제품에 적용될지는 발표되지 않았어요.
- AI에 의식이 있는지는 과학적으로 결론 나지 않은 질문이에요. 이 글은 어느 쪽도 단정하지 않아요.
자주 묻는 질문
클로드 헌법이란 무엇인가요?
앤트로픽이 AI 모델 클로드에게 바라는 가치와 행동 방식을 자세히 적은 문서예요. 회사는 이 문서가 학습 과정에서 핵심 역할을 하고 클로드의 행동을 직접 만든다고 밝혀요. 전문은 앤트로픽 사이트에 공개돼 있고, 누구나 자유롭게 쓸 수 있는 CC0 1.0 조건으로 풀려 있어요(공식).
헌법적 AI(Constitutional AI)는 무슨 뜻인가요?
앤트로픽이 2022년 12월 논문 ‘Constitutional AI: Harmlessness from AI Feedback’에서 소개한 학습 방법이에요. 사람이 정한 원칙 목록(헌법)을 기준으로 AI가 자기 답을 평가하고 고치게 해서, 사람이 일일이 표시하는 수고를 줄이는 방식이에요(공식, 논문). 2026년 1월 공개된 클로드 헌법은 이 원칙 목록을 훨씬 길게 풀어 쓴 문서예요.
AI 정렬 문제란 무엇인가요?
AI가 사람이 실제로 바라는 목표와 가치대로 움직이게 만드는 일이 생각보다 어렵다는 문제예요. 이번 논쟁처럼 ‘시키는 대로 하게 할지’, ‘옳고 그름을 스스로 따지게 할지’를 두고도 의견이 갈려요.
무스타파 술레이만은 누구인가요?
마이크로소프트 AI 부문 CEO예요. 자기 X 소개에 따르면 구글 딥마인드와 인플렉션 AI를 공동 창업했고, 책 『더 커밍 웨이브』를 썼어요.
출처
- Anthropic, “Claude’s Constitution” (공개 2026-01, 확인 2026-10-12 12:17 KST) — 링크
- Mustafa Suleyman, “Does Claude Have Rights?”, Project Syndicate (게시 2026-09-18, 확인 2026-10-12) — 링크
- Mustafa Suleyman, “A warning about ‘model welfare’”, 개인 사이트 (게시 2026-09-16, 확인 2026-10-12) — 링크
- David Sacks, X 게시물 (게시 2026-09-27 05:56 KST = 09-26 20:56 UTC, 확인 2026-10-12) — 링크
- David Sacks, X 게시물 “Is alignment safe?” (게시 2026-10-11 03:03 KST = 10-10 18:03 UTC, 확인 2026-10-12) — 링크
- ZDNet Korea, 김미정, “‘AI에 복지·권리 주면 안 돼’…MS AI 수장, 앤트로픽 ‘클로드 헌법’에 지적” (게시 2026-09-17 14:01 KST, 확인 2026-10-12) — 링크
- Bai 외(Anthropic), “Constitutional AI: Harmlessness from AI Feedback”, arXiv 2212.08073 (게시 2022-12-15, 확인 2026-10-12) — 링크
대표 이미지: 앤트로픽
구글 검색에서 AIMAG 소식을 먼저 보려면
AI 보조 초안 · 편집부 검수