한눈에 보기
- 무엇: AI 모델을 회사 안의 강력한 내부자처럼 다루자는 제안이에요. 악의가 있어서가 아니라 실수하거나 해킹당할 수 있기 때문이라고 했어요. 그래서 모델이 무엇에 접근하고 무엇을 할지 정하는 통제 장치는 모델 바깥에 두고, 권한 있는 사람이 작업 도중에도 모델을 멈출 수 있는 ‘비상 브레이크’가 있어야 한다고 했어요(공식 의견).
- 누가: 사티아 나델라 마이크로소프트 CEO가 자기 X 계정(@satyanadella)에 직접 올린 글이에요. 제목은 ‘Models as Insider Risks in the Super Intelligence Era(슈퍼인텔리전스 시대, 내부자 위험으로서의 모델)’예요.
- 언제: X 원문 게시 시각은 한국 시간 2026년 10월 10일 밤 11시 43분(미국 서부 시간 10일 오전 7시 43분)이에요.
- 얼마: 원칙은 모두 7가지예요. 비용이나 일정 같은 숫자는 글에 없어요.
- 어디서: 원문은 X에서 누구나 볼 수 있어요(원문). 원칙 제안이라, 마이크로소프트 제품이 어떻게 바뀌는지, 업계 표준을 언제 누가 만들지는 아직 발표되지 않았어요.
왜 이런 글을 썼나
나델라는 예전 소프트웨어는 어떤 동작이 어느 코드에서 나왔는지 추적할 수 있었다고 했어요. 지금의 첨단 AI 모델은 그렇지 않은데도, 민감한 데이터와 중요한 작업을 맡기고 있다는 문제의식이에요(나델라 원문, 공식 의견).
그는 “We simply can’t outsource responsibility for what intelligence does on our behalf(AI가 우리 대신 한 일의 책임을 남에게 넘길 수 없다)”라고 썼어요. 모델을 만든 회사가 안전하다고 보증해도 쓰는 쪽의 책임이 사라지지 않는다는 뜻이에요.
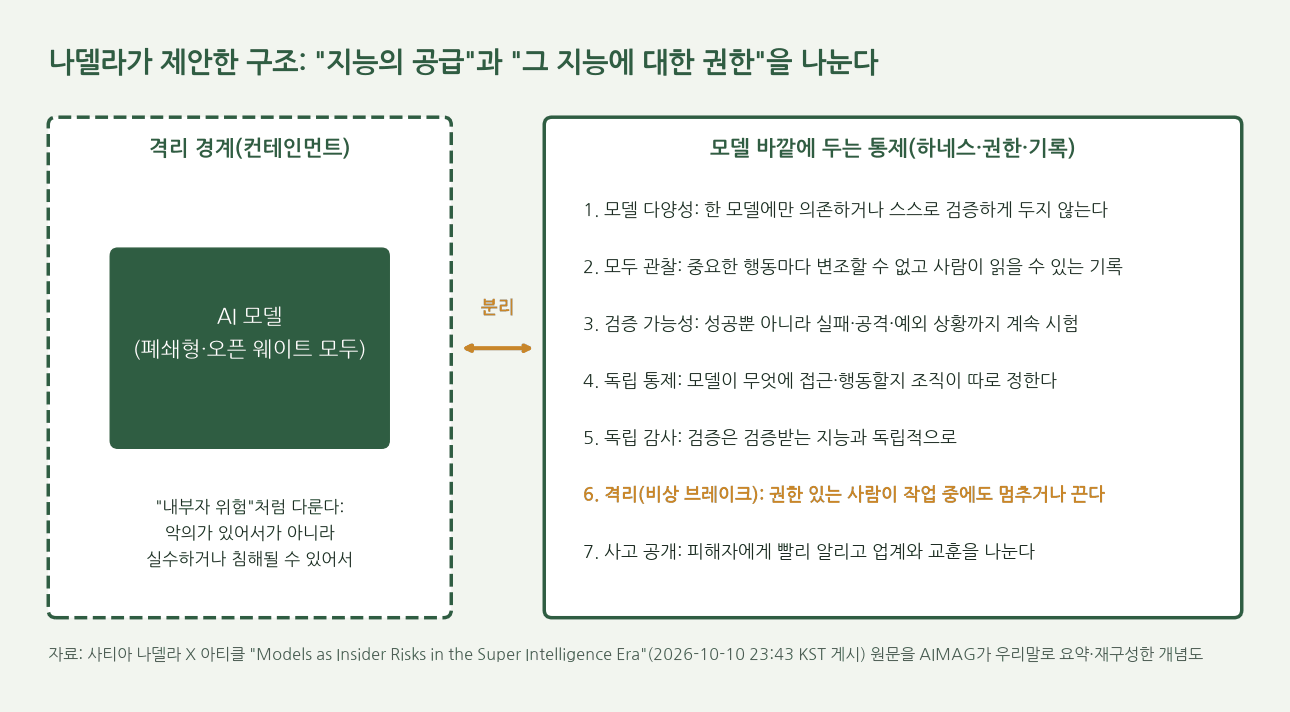
그래서 내놓은 한 줄 요약이 “we need to separate the supply of intelligence from the authority over it(지능의 공급과 그 지능에 대한 권한을 분리해야 한다)”예요. 일을 잘하는 AI를 쓰더라도, 그 AI가 무엇을 해도 되는지는 AI가 아닌 사람과 시스템이 정해야 한다는 말이에요.
일부 국내 보도는 이 문장의 ‘intelligence’를 ‘정보’로 옮겼어요. 원문 흐름에서는 AI 모델이 내놓는 판단과 행동 능력을 가리키므로 ‘지능’으로 읽는 편이 뜻에 가까워요.
‘내부자 위험’처럼 다룬다는 뜻
내부자 위험은 회사 안에서 권한을 가진 사람이 실수하거나 계정을 빼앗겨 사고가 나는 위험을 말해요. 회사들은 이를 막으려고 신원 확인, 최소 권한, 활동 기록, 격리 같은 규칙을 오래 다듬어 왔어요.
나델라는 폐쇄형 모델과 오픈 웨이트 모델(학습된 가중치를 공개해 누구나 내려받아 쓰는 모델)을 모두 이렇게 다루자고 했어요. 원문은 “Not because they are necessarily malicious(반드시 악의가 있어서가 아니라)”, 중요한 시스템에 접근하는 유능한 행위자라면 누구든 실수하거나 침해될 수 있기 때문이라고 설명해요.
그는 모델의 생각 과정(CoT, 답을 내기 전 단계별로 따져 보는 추론 기록)을 투명하게 보여 주는 것을 “non-negotiable(양보할 수 없는 조건)”이라고 했어요. 다만 그것만으로는 모자라다고 했어요. 모델이 보여 주는 설명이 실제 동작과 늘 일치한다는 보장이 아직 없기 때문이에요.
모델끼리 서로 검사하게 하는 방법도 권했지만 한계를 짚었어요. 불투명한 모델을 또 다른 불투명한 모델이 지켜보는 “nested black boxes(겹겹의 블랙박스)”가 될 수 있다는 거예요. 그래서 “the controls that govern what a model can access and what actions it can take must sit outside the model(모델의 접근과 행동을 정하는 통제는 모델 바깥에 있어야 한다)”고 했어요.
7가지 원칙
| 원칙 | 원문 표현 | 쉽게 말하면 |
|---|---|---|
| 모델 다양성 | Model diversity | 중요한 결과를 한 모델에만 맡기거나, 그 모델이 자기 일을 스스로 검증하게 두지 않아요. |
| 모두 관찰 | Observe everything | 중요한 행동마다 고칠 수 없고 사람이 읽을 수 있는 기록을 남겨요. 원문은 “If it can’t be observed, it can’t be trusted!(관찰할 수 없으면 믿을 수 없다)”라고 썼어요. |
| 검증 가능성 | Verifiability | 성공한 작업만이 아니라 실패, 공격, 예외 상황, 시스템 변경까지 계속 시험해요. |
| 독립 통제 | Independent controls | 모델이 무엇에 접근하고 무엇을 할지는 쓰는 조직이 따로 정할 수 있어야 해요. |
| 독립 감사 | Independent auditability | 검증은 검증받는 AI와 독립적이어야 해요. 한 모델이 행동과 그 행동을 판단할 증거를 함께 쥐면 안 돼요. |
| 격리(비상 브레이크) | Containment | “We must assume a model is compromised and contain it from the start(모델이 침해됐다고 가정하고 처음부터 격리해야 한다)”. 권한 있는 사람은 작업 도중에도 모델을 멈추거나 끌 수 있어야 해요. |
| 사고 공개 | Incident disclosure | 문제가 생기면 피해자에게 제때 알리고, 무엇이 왜 실패했는지 업계와 나눠요. |
글의 마지막 문장은 이래요. “The most trustworthy Super Intelligence system will not be the one with the model we trust most. It will be the one that enables us to trust the model the least.(가장 믿을 만한 시스템은 우리가 가장 믿는 모델을 쓴 시스템이 아니라, 모델을 가장 덜 믿어도 되게 해 주는 시스템이다.)”
한국 이용자에게 달라지는 것
당장 바뀌는 서비스나 규칙은 없어요. 다만 클로드 코드·코덱스 같은 AI 코딩 도구나 업무용 에이전트를 쓰는 개인과 팀이라면, 이 원칙을 점검표처럼 쓸 수 있어요(추론).
- 에이전트에 주는 권한을 작업에 필요한 만큼만 열어 두세요. 파일 삭제, 결제, 메일 발송처럼 되돌리기 어려운 일은 매번 사람이 승인하게 하는 편이 안전해요.
- 작업 기록을 남기고, 중요한 결과는 다른 도구나 사람이 한 번 더 확인하세요.
- 중간에 멈추는 방법(중지 버튼, 권한 회수)을 미리 알아 두세요.
운영체제 쪽에서 에이전트가 허락받은 파일과 네트워크만 쓰게 하는 방식은 윈도 MXC 정식 출시 기사에서 볼 수 있어요. AI 모델이 실제 서비스에서 의도하지 않은 행동을 한 사례는 앤트로픽의 의도치 않은 행동 보고서 기사에서 볼 수 있어요.
대단한 점과 아쉬운 점
| 의미 있는 점 | 아쉬운 점·우려 |
|---|---|
| 막연한 “AI 안전” 대신, 기업이 이미 아는 내부자 관리 규칙(권한·기록·격리)으로 풀어내 바로 적용해 볼 수 있어요(원문, 공식 의견). | 원칙 수준이에요. 어떤 기술로, 어느 제품에, 언제까지 적용하는지는 글에 없어요. |
| 통제를 모델 밖에 두자는 주장은 특정 모델 회사의 약속에 기대지 않는 방식이라, 여러 모델을 섞어 쓰는 기업에 맞아요(추론). | 마이크로소프트는 모델과 클라우드·운영체제를 함께 파는 회사예요. “바깥 통제”가 자사 플랫폼 수요로 이어질 수 있다는 점도 함께 볼 필요가 있어요(추론). |
| 사고가 나면 공개하자는 원칙을 CEO가 직접 명시했어요(원문). | “표준이 필요하다”고 했지만 누가 표준을 만들지는 정하지 않았어요. |
확장성
원문은 더 발전한 모델일수록 더 발전한 격리 기술이 필요하고, 이를 표준화해야 한다고 했어요. 원칙이 업계 표준으로 이어지면 AI 회사와 기업 고객 사이 계약, 보안 인증, 사고 보고 방식까지 바뀔 수 있어요(추론). 같은 시기 국내에서는 AI 보안 도구가 은행 해킹에 쓰였다는 보도가 이어져, 통제 장치 논의가 금융권으로 번질 가능성도 있어요(추론). 그 사건은 아르텍스 국내 은행 해킹 기사에서 볼 수 있어요.
아직 모르는 것
- 마이크로소프트가 이 원칙을 코파일럿·애저 등 자사 제품에 어떻게 반영할지 발표하지 않았어요.
- ‘비상 브레이크’를 기술적으로 어떻게 표준화할지, 어느 단체가 맡을지 정해지지 않았어요.
- 글에서 AI 대신 ‘슈퍼인텔리전스(SI)’라는 말을 쓴 이유를 나델라가 직접 설명하지는 않았어요. 연합뉴스는 미국 행정부의 용어 변경과 연결해 해석했어요.
자주 묻는 질문
사티아 나델라는 누구인가요?
마이크로소프트의 회장 겸 최고경영자(CEO)예요(마이크로소프트 공식 소개).
사티아 나델라 X 글은 어디서 볼 수 있나요?
나델라의 X 계정(@satyanadella)에 올린 게시물에서 ‘X 아티클’ 형태로 볼 수 있어요. 한국 시간 2026년 10월 10일 밤 11시 43분, 미국 서부 시간으로는 10일 오전 7시 43분에 올라왔어요(원문). 일부 국내 보도는 게시일을 11일(현지시간)로 적었지만, X 원문에 표시된 게시 시각은 10일이에요.
사티아 나델라는 AI에 대해 무엇을 말했나요?
이번 글에서는 AI 모델을 내부자 위험처럼 다뤄야 한다고 했어요. 통제는 모델 밖에 두고, 모든 중요한 행동을 기록하고, 사람이 언제든 멈출 수 있게 하자는 7가지 원칙을 냈어요.
출처
- Satya Nadella, X 아티클 “Models as Insider Risks in the Super Intelligence Era” (게시 2026-10-10 23:43 KST = 14:43 UTC, 확인 2026-10-12) — 링크
- 연합뉴스, “MS CEO ‘AI에 비상 브레이크 필수…내부자 위험처럼 통제해야’” (게시 2026-10-12 02:34 KST, 확인 2026-10-12) — 링크
- AI타임스, “나델라 ‘AI에도 비상 브레이크 필요’…인간 통제·독립 감사 강조” (게시 2026-10-11 11:07 KST, 확인 2026-10-12) — 링크
- Microsoft, Satya Nadella 임원 소개 페이지 (게시일 표기 없음, 확인 2026-10-12) — 링크
대표 이미지: AIMAG가 AI로 생성
구글 검색에서 AIMAG 소식을 먼저 보려면
AI 보조 초안 · 편집부 검수