로컬에서 AI 모델을 돌리는 대표적인 길은 두 갈래였어요. llama.cpp 계열(Ollama·LM Studio·Jan의 엔진)로 GGUF 파일을 돌리거나, Hugging Face Transformers로 원본 체크포인트를 PyTorch에서 다루거나요. 전자는 가볍고 빠른데 모델 내부를 만지기 어렵고, 후자는 실험에 좋지만 큰 모델을 노트북에 올리기엔 무거웠어요.
허깅페이스가 9월 22일 이 둘을 잇는 기능을 내놨어요. Transformers에서 GGUF 모델을 효율적으로 실행할 수 있게 된 거예요. from_pretrained에 gguf_file을 넘기는 것만으로 동작해요.
기술적으로 무엇을 했나
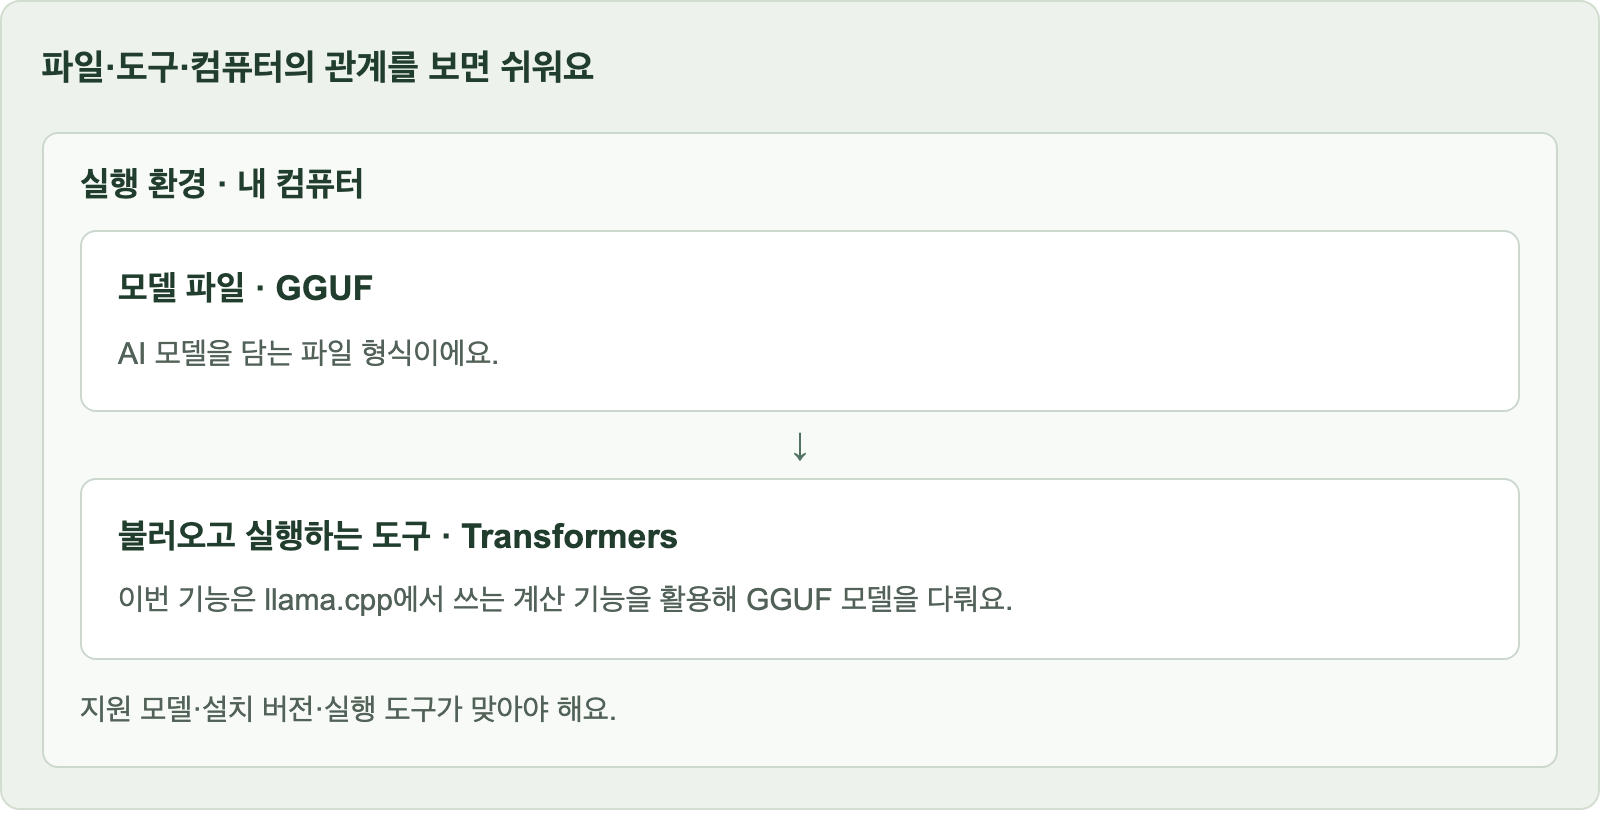
핵심은 Transformers를 llama.cpp로 갈아끼운 게 아니라, llama.cpp의 밑바닥 ggml 커널을 kernels 라이브러리를 통해 PyTorch 안에서 재사용했다는 거예요. 발표에 실린 커널 구성은 이래요.
| 커널 | 역할 |
|---|---|
ggml-quantization |
패킹된 양자화 가중치를 그대로 읽어 행렬 연산(MoE의 선택된 expert 포함). 매 토큰마다 가중치를 풀지 않아 메모리를 아껴요 |
ggml-norm |
Qwen3.5·Qwen3.8의 zero-centered RMSNorm 같은 정규화를 한 번에 처리 |
ggml-attn |
Metal 플래시 어텐션 — 프롬프트 처리와 토큰 디코딩 |
ggml-gated-delta-net |
Qwen3.5·Qwen3.8 하이브리드 구조의 linear-attention 층 가속 |
topk |
MoE 모델에서 토큰별 expert 선택(softmax + top-k 라우팅) — 허깅페이스 자체 Metal 구현 |
generate 쪽 최적화도 같이 들어갔어요 — 패딩이 없는 입력의 attention mask를 초반에 버리고(#48814), 중단 조건 확인을 비동기로 미뤄서 GPU가 쉬는 시간을 줄였어요(#47975). 이 두 변경은 GGUF가 아닌 모든 Transformers 모델에도 적용돼요.
측정은 MacBook Pro M2 Max(32GB)에서 진행했고, 세 체크포인트(작은 dense·큰 dense·MoE)에서 “llama.cpp에 근접”이라는 게 회사 설명이에요. 주의: Transformers 측정은 prefill을 포함하고 llama-bench는 디코딩만 잰 거라 완전히 동일 조건은 아니라고 본문에 명시돼 있어요.
GGUF 파일 형식, 간단히
GGUF는 가중치·토크나이저 정보·채팅 템플릿을 한 파일에 담는 형식이에요. 양자화 수준별로 크기가 달라져요 — Unsloth의 Qwen3.5-4B 기준으로 BF16은 8.42GB인데 Q4_K_M은 2.74GB예요. 실전 시작점으로 Q4_K_M을 권하고, 메모리 여유가 있으면 Q5_K_M·Q6_K로 정밀도를 올리라고 해요. 품질 손실은 모델과 작업에 따라 다르니 직접 평가가 필요해요.
조건과 한계
| 확인할 것 | 발표 당시 안내 |
|---|---|
| 하드웨어 | Apple Silicon 맥 우선 지원 |
| 모델 | Qwen3.5 구조부터 시작 |
| 설치 | Transformers 최신 개발 버전 + 호환 kernels 버전 (pip install -U "git+https://github.com/huggingface/transformers.git" kernels) |
| PyTorch | ggml 커널 빌드가 지원하는 버전(보통 최신 2개 릴리스) |
커널을 못 받으면 모델을 dequantize(양자화를 풀어 큰 형태로 로드)해서 메모리가 늘어나요 — sdpa 폴백으로 경고와 함께 동작해요. 그리고 회사가 직접 밝히듯 “효율적인 로컬 실행이 목적이면 llama.cpp가 여전히 권장 엔진”이에요. 이번 기능의 용도는 다르거든요:
- Python/PyTorch에서 GGUF 모델의 중간 활성값을 훅으로 들여다보거나 forward를 바꾸는 실험
- 기존 Transformers 평가 워크플로로 양자화 체크포인트 품질 재기
- 원본↔GGUF 변환 검증
GgufConfig(dequantize=True)로 양자화를 풀어 파인튜닝 진입transformers serve로 OpenAI 호환 API 엔드포인트 띄우기(Jan·Pi 같은 클라이언트 연결)
장기적인 함의도 있어요. 커널은 텐서 연산이라 GGUF가 아닌 모델에도 붙을 수 있어서, llama.cpp 전용 구현이 없는 새 아키텍처·비전·오디오 모델까지 ggml 성능을 가져올 길이 열렸다는 게 회사의 설명이에요.
출처
- Hugging Face, Transformers now runs llama.cpp quants, 2026-09-22. 원문 확인: 2026-09-30.
대표 이미지: 허깅페이스
구글 검색에서 AIMAG 소식을 먼저 보려면
AI 보조 초안 · 편집부 검수