
한눈에 보기
- 무엇: 앤트로픽이 ‘증류 공격’을 막는 새 방어 3가지를 공개했어요. 증류 공격은 클로드의 답과 추론을 몰래 대량으로 모아 다른 회사 모델을 가르치는 일이에요. 증류꾼이 빼낸 데이터가 약 90~99% 줄었다고 밝혔어요(공식, 회사 측정).
- 누가: 클로드를 만드는 미국 AI 회사 앤트로픽이에요.
- 언제: 2026년 10월 12일(미국 시간) 발표했어요. 한국 시간으로는 10월 12일 오후 6시 30분이에요.
- 얼마: 정상 요청을 잘못 막는 비율은 0.1% 미만이라고 밝혔어요. 9월 24일부터는 막힌 요청에도 요금을 다시 받아요(공식).
- 어디서: 앤트로픽 API와 클로드 최상위 모델에 적용돼요. 한국 개발자도 같은 API를 쓰니 그대로 영향을 받아요(공식 내용 기준 추정).
결론부터 말하면, 앤트로픽은 클로드의 ‘생각 과정’이 밖으로 새지 않게 막는 데 방어의 거의 전부를 걸었어요(공식). 효과는 컸다고 밝혔지만, 정상 이용자도 연동 수정·드문 오차단·요금이라는 비용을 함께 지게 됐어요(공식).
용어부터 짧게 풀게요. 증류(distillation)는 큰 모델의 답을 많이 모아 작은 모델에 가르치는 학습 방법이에요. 앤트로픽이 말하는 증류 공격은 허락 없이 가짜 계정을 대량으로 만들어 클로드의 답을 수확하고, 그걸로 다른 회사 모델을 학습시키는 일이에요(공식 정의).
왜 ‘추론’이 표적이 되나요?
앤트로픽에 따르면 증류꾼에게 가장 값진 자료는 클로드가 답하기 전에 쓰는 추론 기록이에요. 추론 기록은 모델이 최종 답에 이르는 생각 과정을 글로 적은 것이에요. 결과만 볼 때보다 ‘어떻게 답에 이르는지’를 작은 모델이 배우기 쉬워진다고 설명했어요(공식).
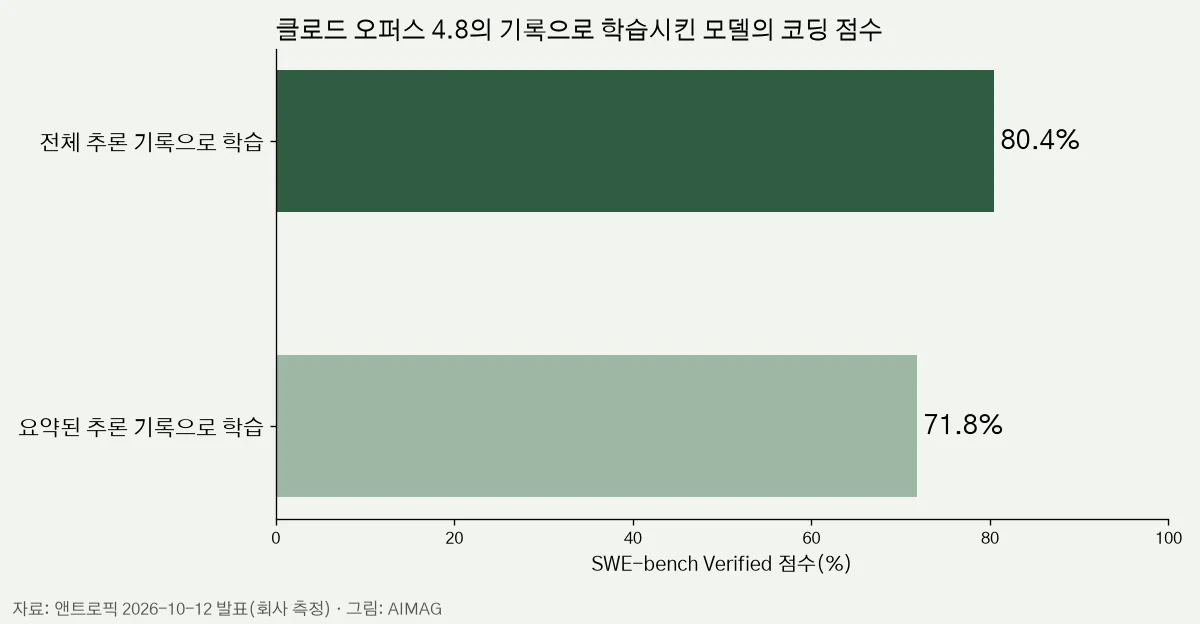
그래서 앤트로픽은 처음에 추론을 요약해서만 보여 줬어요. 회사는 코딩 시험 SWE-bench Verified(실제 오픈소스 프로그램의 버그를 고치게 하는 평가)로 효과를 쟀어요. 클로드 오퍼스 4.8의 전체 추론으로 학습한 모델은 80.4%를 받았어요. 요약된 추론으로만 학습하면 71.8%였어요(공식, 회사 측정). 오픈소스는 누구나 보고 고칠 수 있게 코드를 공개한 소프트웨어예요.
그러자 공격이 바뀌었어요. “이전 추론을 글자 그대로 출력하라” 같은 단순한 요청부터, 한 연구소가 서로 다른 속임수 요청 1만 2,000개를 시험한 사례까지 있었다고 해요(공식). 2월 보고서에는 한 조직이 가짜 계정 2만 개 이상을 동시에 굴린 사례도 나왔다고 밝혔어요(공식).
새 방어 3가지
| 방어 | 무엇을 하나 | 적용 대상(회사 발표) |
|---|---|---|
| ① 날 추론을 넘기지 않기 | ‘보존된 사고(preserved thinking)’로 새 계정이 클로드의 이전 대화 내용을 고칠 수 없게 했어요. 다른 대화·다른 모델·다른 계정으로 추론을 옮겨 빼내는 길을 막는 장치예요. | 클로드 페이블 5.1·오퍼스 5.5, 2026년 8월 31일부터 만든 API 계정. 소네트 5.5는 추론을 그 요청을 보낸 조직만 볼 수 있어요. |
| ② 2단계 분류기 | 추론을 빼내려는 요청을 두 단계로 걸러내는 감시 모델이에요. 생물무기 제작 도움을 막는 장치와 비슷한 수준으로 튼튼하다고 밝혔어요. | 소네트 5.5, 오퍼스 5·5.5, 페이블 5·5.1 |
| ③ 반복 시도 제재 | 추론을 계속 빼내려는 계정은 사용 한도를 더 좁히고, 끈질기면 계정을 정지해요. | 증류로 판단한 계정. 수만 개를 정지했고, 공격 시작 2시간 안에 막은 경우가 많다고 밝혔어요. |
분류기는 들어온 요청이 어떤 종류인지 판별하는 별도 AI예요. 앤트로픽은 자사 ‘헌법 분류기’ 연구와 같은 방식으로 이 분류기를 만들고, 내부·외부 레드팀으로 뚫어 본 뒤 구멍을 막았다고 했어요(공식). 레드팀은 일부러 공격자 역할을 맡아 약점을 찾는 시험이에요.
분류기는 계속 고쳐 가요. 예전 추론을 다른 언어로 번역해 달라거나, 답 옆에 태그로 적어 달라는 새 수법도 이미 막았다고 밝혔어요(공식).
효과는 얼마나 됐나요?
앤트로픽은 자사 플랫폼에서 증류꾼이 빼낸 추론 토큰(AI가 글을 처리하는 작은 단위)이 분류기 도입 뒤 꾸준히 10~100배 줄었다고 밝혔어요. 어떤 날은 너무 적어 측정이 안 될 정도였다고 해요(공식, 회사 측정). 9월 보고서에서 설명한 증류 수법은 모두 잡아낸다고도 했어요(공식).
다만 회사 스스로 한계를 적었어요. 효과가 얼마나 오래갈지 모르고, 고도로 정교하고 끈질긴 우회 시도는 아직 보지 못했다고 밝혔어요(공식). 수치는 모두 앤트로픽이 자기 플랫폼에서 잰 값이고, 외부 기관이 검증한 결과는 발표에 없어요(발표 원문 기준).
정상 이용자가 치르는 비용
| 비용 | 회사가 밝힌 내용 |
|---|---|
| 잘못 막힘(오탐) | 분류기가 0.1% 미만의 경우 정상 요청을 잘못 판단하거나 막을 수 있어요. |
| 연동 수정 | 보존된 사고 때문에 일부 개발자는 연동 코드를 고쳐야 했어요. |
| 요금 | 9월 24일부터 클로드가 답하기 전에 막힌 요청도 요금을 받아요. 오탐률이 0.1% 미만인 영역(증류 포함)에만 적용해요. |
앤트로픽은 2월에 “정상 이용자 경험에 영향을 주지 않겠다”고 했지만 그 목표를 완전히 지키지는 못했다고 인정했어요(공식). 오탐률이 0.1% 미만이어도 요청을 아주 많이 보내는 서비스라면 막히는 건수 자체는 적지 않을 수 있어요(추정).
지푸와 문샷은 어떻게 언급됐나요?
앤트로픽은 중국 AI 회사 지푸(Zhipu)가 GLM-5.3을 만들면서 미국 선두 모델의 사이버 보안 능력을 증류했다고 밝혔어요. 지푸는 클로드 페이블 5를 증류하려다 안전장치에 막히자 옛 클로드 모델과 다른 연구소 모델로 바꿨다고 해요(앤트로픽 주장).
개방 가중치 모델은 모델 파일을 누구나 내려받아 쓸 수 있게 공개한 모델이에요. 앤트로픽은 미국 기관 CAISSI가 GLM-5.3을 이런 모델 중 사이버 능력이 가장 높다고 평가했다고 전했어요. CAISSI는 ‘Center for Advancing Innovation and Standards for Super Intelligence’의 약자예요. 자체 연구에서는 GLM-5.3의 안전장치를 쉽게 우회할 수 있었다고 했어요(앤트로픽 주장).
문샷(Moonshot)에 대해서는 키미(Kimi) 모델로 들어온 요청이 증류 작업의 일부로 클로드에 몰래 전달된 사례를 앞서 보고했다고 썼어요. 그중 한 요청은 특정인의 CCTV 감시 영상 분석을 원했고, 앤트로픽은 그 이용자가 중국 인민해방군과 관련 있다고 본다고 밝혔어요(앤트로픽 주장). 두 회사의 반론은 이번 발표에 실려 있지 않아요(발표 원문 기준).
한국 이용자에게는 무엇이 달라지나요?
클로드 API로 서비스를 만드는 국내 개발자라면 세 가지를 확인해 볼 만해요(추정). 첫째, 8월 31일부터 만든 계정으로 페이블 5.1·오퍼스 5.5를 쓰는 경우예요. 이전 대화의 추론 블록을 고쳐 다시 보내는 코드가 있다면 동작이 달라질 수 있어요(공식 내용 기준). 둘째, 소네트 5.5의 추론을 다른 조직 계정에서 읽는 구조라면 막혀요(공식). 셋째, 막힌 요청도 과금되니 요청이 거부된 기록과 청구서를 함께 보는 게 좋아요(추정).
오픈AI도 비슷한 추출 캠페인을 막았다고 밝힌 적이 있어요. 그 내용은 오픈AI 보호된 추론 추출 차단 기사에서 볼 수 있어요.
대단한 점과 아쉬운 점
| 의미 있는 점 | 아쉬운 점·우려 |
|---|---|
| 방어 방법과 함께 오탐·연동 수정·요금 같은 비용을 회사가 먼저 공개했어요(공식). | 효과 수치는 모두 회사 측정이고, 외부 검증 결과는 없어요(발표 원문 기준). |
| 요약 추론의 효과를 SWE-bench 점수 차이(80.4% → 71.8%)로 숫자로 보여 줬어요(공식, 회사 측정). | 요약해도 71.8%가 남는다는 건, 요약본만으로도 상당한 학습 효과가 있다는 뜻으로도 읽혀요(추정). |
| 다른 개발사와 클라우드 플랫폼도 함께 막아야 한다며 방법을 공개했어요(공식). | 막힌 요청에 요금을 받는 정책은 오탐을 당한 정상 이용자에게 부담이 돼요(추정). |
확장성
이번 방식은 다른 모델 회사도 따라 할 수 있어요. 앤트로픽은 증류꾼이 자사 API뿐 아니라 외부 클라우드와 다른 추론 제공 업체로 트래픽을 나눠 보낸다고 밝혔어요. 그래서 플랫폼도 가짜 계정을 빨리 찾아 내보내야 한다고 했어요(공식).
개발자 쪽에서는 ‘추론은 요청한 조직 안에서만 본다’는 원칙이 표준이 될 수 있어요. 에이전트 서비스는 여러 단계 작업을 스스로 처리하는 AI 서비스예요. 여러 모델을 이어 붙이는 에이전트 서비스라면 추론 대신 결과만 넘기는 설계로 바뀔 수 있어요(추정). 클로드 소네트 5.5의 기본 정보는 클로드 소네트 5.5 기사에서 볼 수 있어요.
아직 모르는 것
- 오탐 0.1% 미만이 어떤 요청을 기준으로 잰 값인지, 오탐 요금을 돌려받을 절차가 있는지는 발표에 없어요.
- ‘보존된 사고’ 때문에 고쳐야 하는 연동 코드가 구체적으로 어떤 형태인지는 이번 글에 자세히 나오지 않아요.
- 지푸·문샷이 앤트로픽 주장에 어떻게 답할지는 아직 알려지지 않았어요.
- 방어가 얼마나 오래 버틸지는 회사도 모른다고 밝혔어요.
자주 묻는 질문
AI 증류 뜻은 무엇인가요?
큰 AI 모델의 답을 많이 모아 작은 모델을 가르치는 학습 방법이에요. 회사가 자기 모델로 하면 정상적인 기술이에요. 앤트로픽이 문제 삼는 건 남의 모델을 허락 없이, 가짜 계정으로 대량 수확하는 ‘증류 공격’이에요.
모델 증류 방법은 어떻게 되나요?
앤트로픽 설명에 따르면 큰 모델에 수백만 개의 질문을 보내 답을 받고, 그 답으로 작은 모델이 큰 모델의 행동을 흉내 내도록 학습시켜요. 답보다 추론 과정까지 모으면 효과가 더 커요. 그래서 이번 방어도 추론을 감추는 데 집중했어요.
Kimi가 클로드를 증류했나요?
앤트로픽은 문샷의 키미 모델로 들어온 요청이 증류 작업의 일부로 클로드에 몰래 전달된 사례를 보고했다고 밝혔어요. 이번 발표에는 그 이상의 세부 내용과 문샷의 입장이 없어요.
지푸 AI GLM은 무엇인가요?
지푸는 중국 AI 회사이고 GLM은 이 회사 모델 이름이에요. 앤트로픽은 지푸가 GLM-5.3을 만들 때 미국 모델의 사이버 능력을 증류했다고 주장했어요. 지푸의 입장은 이번 발표에 실려 있지 않아요.
앤트로픽은 뭐 하는 회사인가요?
AI 모델 ‘클로드’를 만드는 미국 회사예요. 클로드는 채팅 서비스와 개발자용 API로 제공되고, 이번 증류 방어도 API와 최상위 모델에 적용됐어요.
출처
- Anthropic, “Strengthening our defenses against distillation attacks” (게시 2026-10-12 09:30 UTC, 확인 2026-10-13 18:20 KST) — 링크
대표 이미지: 앤트로픽
구글 검색에서 AIMAG 소식을 먼저 보려면
AI 보조 초안 · 편집부 검수